設計書がない古いシステムの仕様は、生成AIでどこまで復元できる?――読み解けること、確認すべきこと
長年使い続けた業務システムを刷新しようとしても、設計書が残っていない。残っていても改修の内容が反映されておらず、当時の担当者もいない。こうした状況では、現行システムが何をしているか分からないまま、移行先の要件や見積もりを検討しなければなりません。
経済産業省の「レガシーシステムモダン化委員会総括レポート(新しいタブで開きます)」(2025年5月)も、ブラックボックス化したシステムの仕様を復元・ドキュメント化し、担当者が代わっても知識を継承できるようにすることの重要性を示しています。
生成AIは、こうした仕様の復元を支援する有力な手段です。残されたソースコードやデータベースの定義を解析し、システムの構造や処理の流れ、業務ルールを読み解く作業を支援できます。
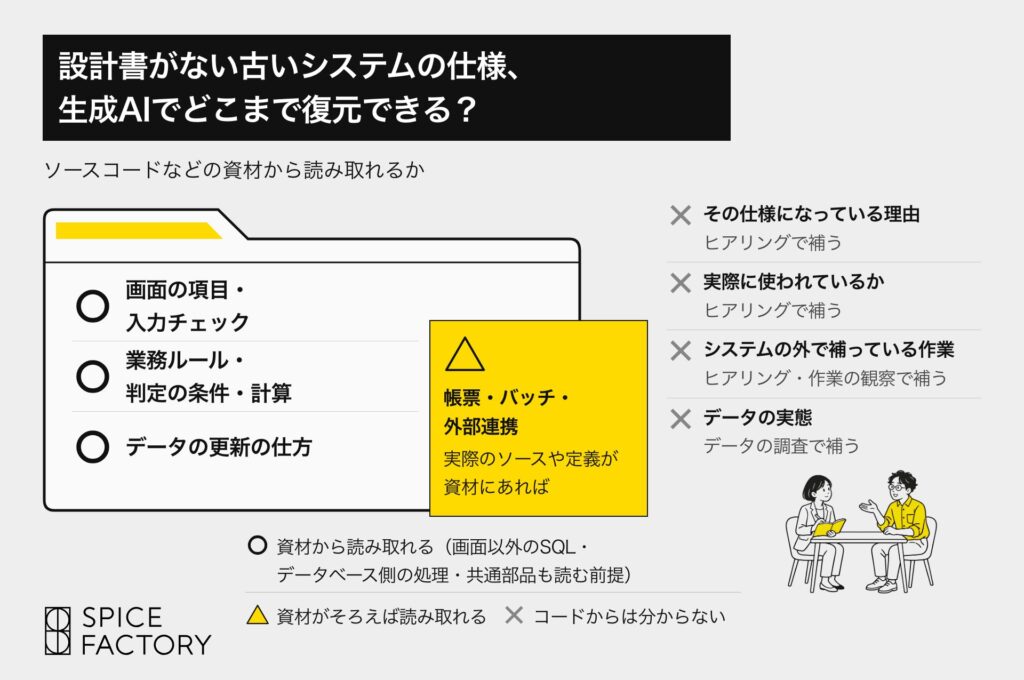
ただし、すべての仕様を同じ精度で復元できるわけではありません。
復元の難しさは、元のシステムの言語やフレームワーク、開発スタイル、手元に残っている資材によっても変わります。
最初から全機能の詳細な仕様書を完成させなくても、生成AIを使って主要機能や構造を広く解析し、システムの全体像を把握することはできます。そのうえで、刷新に向けて重要な領域を選び、必要な精度まで調査と検証を深めていくことが現実的です。
本記事では、生成AIで何を読み解けるのか、どこに見落としが生じるのか、解析結果をどう確かめるのかを、当社が取り組む業務システムの解析・刷新で得た知見とともに説明します。
設計書がない場合の進め方を含めた、刷新の相談先の選び方は「生成AIでレガシーシステムを刷新する相談先の選び方」で紹介しています。
「仕様の復元」で分かること、分からないこと
設計書のないシステムの「仕様を復元する」とは、失われた設計書を元どおりに再現することではありません。残された資材から現行システムの構造や実装上の規則を読み解き、必要に応じて実際の動作や業務運用と照合しながら、現在の仕様を明らかにすることです。
ここでは、四つの情報を区別する必要があります。
一つ目は、コードや設定に表れた「実装上の規則」です。
例えば、入力値のチェック、金額の計算、承認条件、データの更新順序などです。生成AIによるソースコード解析が直接扱いやすい領域ですが、処理が複数の場所に分かれている場合は、それらの関係まで正しく読み解く必要があります。
二つ目は、「本番で実際に起きる振る舞い」です。
コードに処理が存在していても、そのバージョンが本番にデプロイされているとは限りません。設定によって無効になっている機能や、データの状態によって変わる動作もあります。コードから予測した動作が、必ずしも実際の環境での動作とはならないこともあります。
三つ目は、「現場の業務運用」です。
システムから出力したデータをExcelで加工する、例外的な申請を電話で確認する、月末に手作業で修正する。こうした業務は、ソースコードには現れません。
四つ目は、「刷新後に必要な要件」です。
現行システムを理解できたとしても、その処理をすべて新システムに引き継ぐ必要があるとは限りません。
例えば、コードから「締め日を過ぎた申請は受け付けない」という条件を読み取れたとします。しかし、その条件が現在の業務規程に合っているのか、なぜ設けられたのか、刷新後も必要なのかは別の問いです。
生成AIによる仕様復元は、まず実装上の規則を読み解くところから始まります。実際の動作、現場の運用、将来の要件を確認するには、それぞれ異なる調査や判断が必要です。
実装仕様も、すべて同じ精度で解析できるわけではない
データベースのテーブル定義のように、構造が明示された情報は比較的抽出しやすいものです。DDLやマイグレーションファイルに定義されている列や制約は、機械的な解析で構造を把握できます。ただし、列の業務上の意味まで自動的に確定できるとは限りません。
基本的な処理フローや計算ルールも、呼び出し関係や条件が明確であれば追跡しやすい領域です。一方、複数のプログラムに処理が分散している場合や、独自のフレームワークを利用している場合は難易度が上がります。
さらに、動的な呼び出し、複雑な例外処理、非同期・並行処理、外部システムとの連携などは、コードを読むだけでは振る舞いを確定しにくく、追加の調査や動作確認が必要になることがあります。
そのため、生成AIによる解析では、機械的に把握できる情報と、AIによる解釈が必要な情報、追加の検証が必要な情報を区別することが有効です。
手元のコードが、現行システムのすべてとは限らない
生成AIによる解析は、受領したソースコードを起点に始められます。最初に必要な資材がすべてそろっていなくても、構造を把握し、不明点を洗い出すことには価値があります。
ただし、渡されたファイルの集合が、実際に調べるべきシステムの全体とは限りません。
例えば、画面やサーバのソースコードがそろっていても、バッチ処理、帳票、外部連携、データベースのストアドプロシージャ、ジョブ定義、設定値などが別の場所に保存されている場合があります。
当社が解析したある業務システムでは、「対象外」と整理されたフォルダの中に、バッチ処理や外部連携の実際のソースコードが含まれていました。
その区分をそのまま信じて解析していたら、重要な機能を調査対象から外してしまう可能性がありました。
この事例が示すのは、解析対象として渡された資材と、システム全体の実体を同一視してはいけないということです。
資材がそろっているかだけでなく、それが現在のシステムに対応しているかも確認が必要です。
リポジトリの最新コミットが、本番環境へデプロイされたバージョンと一致するとは限りません。別ブランチでの修正や、デプロイ時に置き換えられる設定によって、コードから推定した動作と本番の動作が異なる場合もあります。設計書が残っていても、現在の実装を正しく表しているとは限りません。
また、「実装されている」「本番環境で利用できる」「実際の業務で使われている」も異なります。年に一度しか使わない帳票が短期間の操作ログに現れないこともあれば、画面は残っていても利用されていない機能もあり得ます。
初期解析では、受領資材の種類、所在、出所、バージョンなどを分かる範囲で整理し、解析できた領域と追加確認が必要な領域を明らかにします。
「未受領」「未調査」「存在しない」を区別することが、その後の調査の出発点になります。
AIがコードを読めても、仕様を正しく理解したとは限らない
生成AIは、個々のプログラムを要約するだけでなく、関連する処理を探し、複数のファイルをまたぐ関係を整理して、機能や業務ルールとして説明できます。
しかし、ソースコードからシステムの振る舞いを読み解くことには、人がコードリーディングする場合と共通する難しさがあります。
例えば、申請データを登録する処理を考えてみます。
アプリケーションのコードでは申請データを登録するだけでも、データベースのトリガによって、変更履歴の記録や関連データの更新が自動的に実行されることがあります。
こうした処理はアプリケーションから明示的に呼び出されないため、プログラムの呼び出し関係を追うだけでは把握できません。データベース側の定義まで調べなければ、データ更新に関する重要な仕様を見落とす可能性があります。
また、処理のつながりを追う難しさはトリガに限りません。依存性注入や設定に基づく呼び出し、動的なメソッド選択、イベント処理、独自の共通基盤など、言語やフレームワーク固有の仕組みによっても、単純な関数名の検索だけでは把握しきれない処理があります。
標準的な処理フローだけでは見落とすものがある
多くのシステムには、繰り返し利用される共通的な設計や処理の構造があります。その構造を理解することで、個々の機能を効率よく読み解けるようになります。
一方、長年改修されてきたシステムでは、すべての機能が同じ構造に従っているとは限りません。
例えば、画面にだけ存在する入力チェックや、特定の権限でのみ実行される処理、通常の操作とは異なる経路で行われるデータ更新などです。
こうした処理は、一般的な機能の流れを理解しただけでは把握できないことがあります。
仕様の復元では、システムの共通的な構造を理解することに加え、そこから外れた処理が存在する可能性も考慮する必要があります。
機械的な解析とAIによる解釈を組み合わせる
プログラムの構造や定義のように、機械的に特定できる情報については、構文解析や静的解析など、再現性の高い方法を活用できます。
同じ入力とルールから同じ結果を得られる、決定論的なアプローチです。
一方、処理が業務上どのような意味を持つのか、複数の処理がどのように関係するのかといった理解には、生成AIの柔軟な解釈能力が役立ちます。
両者には異なる強みがあります。構造を正確に把握することと、その意味を読み解くことを適切に組み合わせることで、AIの能力を活かしながら解析の信頼性を高められます。
ただし、機械的な解析でも、動的な呼び出しや実行環境に依存する動作まで自動的に把握できるとは限りません。
LLMは、根拠のない説明を補ってしまうことがある
生成AIには、コード読解そのものの難しさとは別に、大規模言語モデル(LLM)に由来する誤りもあります。
LLMは、与えられた文脈と学習で獲得したパターンをもとに文章を生成します。一般的なプログラム構造を説明することには長けていますが、必要な情報が欠けている場合に、典型的な実装パターンをもとに説明を補ってしまうことがあります。
当社の解析でも、初期のAI生成結果に、元のコードには存在しない処理の呼び出し関係が書かれたり、実際には存在する入力チェックが「記述なし」と扱われたりする誤りが見つかりました。
前者は根拠のない処理関係の付加、後者は実在する処理の取りこぼしです。
どちらも自然な文章として出力されるため、仕様書を読んだだけでは誤りに気づきにくいことがあります。
コード検索や構文解析、テスト実行などをAIと組み合わせれば、根拠を集め、こうした誤りを減らすことはできます。ただし、生成された説明と原典のコードが整合しているかは、別途確かめる必要があります。
AIが復元した仕様をどう検証するか
生成AIによる解析結果の信頼性を考えるうえでは、「正確性」と「網羅性」を分けて評価する必要があります。
・正確性: 書かれている仕様が、元のコードや設定と整合しているか。
・網羅性: 目的に必要な機能や処理、重要な例外が抜けていないか。
記述された内容がすべて正しくても、重要な業務ルールが調査対象から漏れていれば、刷新の判断材料としては不十分です。
正確性:記述された仕様の根拠を確かめる
例えば、生成された仕様書に「締め日を過ぎた申請は受け付けない」と書かれていたとします。
元のコードにそれらしい条件分岐が存在することだけでは、その説明が正しいとは断定できません。
条件を取り違えていないか、別の処理経路がないか、設定やデータによって動作が変わらないかを確認します。
生成AIの説明を検証する際には、原典となるソースコードや設定を根拠として照合することが重要です。AI自身に確認を求めるだけでは、同じ誤った前提から同じ結論を導いてしまう可能性があります。
旧システムを実際に動かせる場合は、代表条件や境界値を使って動作を確認できます。
一方、実行環境がない場合、コードから導いた期待結果は、あくまでコードの読解結果です。実際の旧システムの動作と一致することまで確認したものではありません。
網羅性:書かれていない重要な処理を探す
正確性の検証が「書かれた内容は正しいか」を調べるのに対して、網羅性の検証では「本来書かれるべきなのに、抜けている内容はないか」を調べます。
例えば、申請登録の仕様書に入力チェックやデータ更新の説明が正確に記載されていても、例外時に実行される処理や、別の経路から更新されるデータが抜けている可能性があります。
レガシーシステムでは、制度変更や個別の業務要望への対応が長年積み重なり、後から追加された処理が、本来の機能とは離れた場所に残っていることがあります。一見無関係に見える古いプログラムや共通部品が、特定の条件やバッチ処理を通じて今も実行されているケースです。主要な処理経路だけを追うと、こうした思いがけない場所で生きているコードを見落とし、仕様書への記載漏れにつながります。
そのため、仕様書に記載された内容の確認に加え、重要な機能や処理が適切に調査されているかを、別の観点から確かめる必要があります。
また、「検索で見つからなかった」ことは、「その処理が存在しない」ことの証明にはなりません。調査対象の資材が不足していたり、検索対象から外れていたりする場合もあるためです。
解析結果を評価する際には、存在しないことを確認できたのか、まだ調べていないのか、確認に必要な材料が不足しているのかを区別することが大切です。
解析結果を受け取ったら確認したいこと
社外の会社に解析を依頼した場合も、社内で生成AIを使った場合も、少なくとも次の情報を確認すると、その成果をどこまで判断に使えるかが分かります。
1. 解析対象: どの資材を受領し、何を解析したか。出所やバージョンに未確認のものはないか。
2. 全体像: 主要機能、システム構造、依存関係、複雑さが集中する領域として何が分かったか。
3. 記述の確かさ: コード上で確認した事実、AIによる推定、実動作で確認した事実が区別されているか。
4. 調査の限界: 資材不足、未調査の領域、確認できていない処理や設定が明示されているか。
5. 追加確認の方針: 何を追加で調べれば、どの判断の確度が高まるか。
初期解析の段階ですべての仕様に詳細な根拠を求める必要はありません。一方、新システムの要件や受入条件として採用する段階では、個々の記述の根拠や重要な例外、必要に応じた実動作の確認まで裏付けを深めます。
仕様をどこまで復元するかは、目的によって変わる
設計書がないシステムを解析するとき、最初からすべての機能について詳細な仕様を確定させる必要があるとは限りません。
求める成果は、解析結果を何に使うかによって変わります。
刷新の可否や概算規模を検討するとき
この段階では、システムの主要機能、全体構造、外部連携、依存関係、技術的な制約、複雑さが集中する領域などを広く把握することに価値があります。
生成AIを活用して受領ソースコードから全体を俯瞰し、刷新範囲や概算見積もり、追加調査の計画を考えるための材料を得ます。
まだ全機能の入力条件や例外時の振る舞いが確定していなくても、構想段階の判断に必要な情報を得られる場合があります。
ただし、その時点で何が未確認なのか、どの前提が変われば見積もりや計画に影響するのかは明らかにしておく必要があります。
新システムの要件や受入条件を決めるとき
再構築する機能が具体的になったら、重要な業務ルールや処理を詳しく検証します。
例えば、金額計算、権限制御、データの整合性、月次・年次の締め処理、外部連携などは、誤認した際の業務影響が大きくなり得る領域です。
こうした機能では、条件分岐や例外処理を追跡し、コード上の根拠と実際の業務を照合します。必要に応じて旧システムの動作を確認し、新システムの設計や受入テストに使える粒度まで仕様を具体化します。
追加調査の優先順位は、業務への影響と不確実性を踏まえて決めます。
「何が分からないか」に加えて、「その不明点がどの判断に影響するか」「何を確かめれば判断できるか」を明らかにすると、調査にかける費用や時間を合理的に選べます。
正しく復元した仕様も、そのまま引き継ぐとは限らない
生成AIによって現行システムの仕様を正確に把握できたとしても、そのすべてを新システムに引き継ぐべきとは限りません。
以前の制度に対応するための条件、現在では使われていない帳票、当時の技術的な制約を回避するための複雑な処理などは、変更や廃止の候補になります。
反対に、不具合に見える振る舞いが、長年の業務運用の前提となっている可能性もあります。コード上は不自然な処理だからといって、その影響を確認せずに変更することはできません。
そのため、復元した仕様をもとに、現場の担当者へのヒアリング、業務手順、利用ログ、実データなどを確認します。
そのうえで、個々の業務ルールや機能について、維持するのか、変更するのか、廃止するのかを検討します。判断を保留する事項については、その理由と必要な追加確認を残します。
生成AIは、こうした判断に必要な材料を整理できます。しかし、何を新システムに引き継ぐかは、業務上の必要性や変更の影響を踏まえて決めることです。
仕様の復元は、過去のシステムを再現することだけが目的ではありません。現行システムを理解し、これから必要なシステムを設計するための土台でもあります。
まとめ――AIで全体像をつかむ。難しいのは、見えていない仕様を見つけること
設計書がない古いシステムでも、生成AIを活用すれば、残されたソースコードから主要な機能や構造を広く把握し、仕様の復元を進められます。
テーブル定義や基本的な処理フローのように比較的把握しやすい情報がある一方、複雑な例外処理や環境に依存する動作には追加の検証が必要です。仕様が決められた理由や現場の利用実態は、コード解析だけでは確定できません。
まず全体を俯瞰して構造と不確実性を把握し、刷新に向けて重要な領域の調査を深めていく。そこでは、機械的な解析と生成AIによる読解を組み合わせ、正確性と網羅性を目的に応じて検証することが有効です。
AIを使った刷新で、理解と検証を開発の進め方にどう組み込むかは、論考「AI時代のレガシー刷新は、何を変えるべきか」で述べています。
最初からすべての仕様を確定させる必要はありません。何が分かっていて、何が未確認で、次に何を確かめればよいのか。その見取り図があれば、刷新の検討を前に進められます。
スパイスファクトリーでは、受領したソースコードを起点とするAI解析から、必要に応じた詳細調査や刷新方針の検討までを支援しています。