AIが変えるレガシー刷新の本質
生成AIは、レガシーシステムの解析と実装を大きく変え始めています。技術者が時間をかけて読み解いていたプログラムから構造や処理を抽出し、新しい技術で動く形まで短時間で作れる。費用と時間の壁で着手が難しかった刷新にも、選択肢が生まれています。
私たちも、異なる言語やアーキテクチャのシステムを対象に、AIによる解析、仕様の構造化、刷新版の実装に取り組んできました。そこで見えてきたのは、従来の仕事を速くするだけでなく、開発の順序や人と機械の役割分担を変えられる可能性です。
ただし、コードを速く読み、速く書けることと、何を作るべきかを正しく理解していることは別です。前提となる理解が間違っていても、AIは筋の通った仕様書を作り、その仕様書と整合するプログラムを実装できます。成果物が整然としているほど、かえって出発点の誤りが見えにくくなる。開発が速くなれば、誤った前提を実装してしまう速度も上がります。
仕様の欠落や暗黙の業務ルール、現行環境での検証の難しさは、以前からある問題です。AIによって新たに生まれたのではありません。変えられるのは、その問題への向き合い方と品質を支える仕組みです。
「速く作れる」先にあるボトルネック
これまで調査と実装に時間を取られていた開発では、読むこと、作ること自体が制約でした。AIがそこを加速すると、「理解を何で確かめるか」「何を引き継ぐか」「完成をどう判断するか」が前面に出ます。すべてを人が一からレビューすれば、AIによる速度向上も失われます。
必要なのは品質保証の再設計です。既知の対象を正確に調べる方法、未知の対象を発見する方法、推論を事実として採用する条件、業務判断を人に委ねる境界を組み合わせる。モデルの性能だけでは、信頼できる成果物にはなりません。
AIが短時間で試作できるなら、作って動かすことも調査の一部になります。そこで生まれた疑問から解析範囲や検証観点を変える。理解、実装、検証、意思決定を往復させることが、私の考えるAIモダナイゼーションの核心です。
誰も正解が分からなくなったシステムをどう紐解くか
通常のソフトウェア開発では、仕様や受入条件を定め、それに対して実装が正しいかを確かめます。ところがレガシー刷新では、その正解となる仕様自体を復元しなければなりません。設計書が残っていても現行の実装と食い違う場合があり、コードを読み切っても業務上の意味や現場の運用までは分からない。検証の基準を作る仕事と、その基準に従って作る仕事が、同時に存在しているのです。
ここでは少なくとも三つを分けて考える必要があります。現行システムが実際にどのように振る舞うか。それが業務にとって何を意味し、今も必要なのか。そして、刷新後には何を維持し、何を変えるのか。コードは最初の問いに重要な手がかりを与えますが、残り二つに対する最終的な答えまで持っているとは限りません。現行の振る舞いを再現できたとしても、望ましい将来像が決まったことにはならないのです。
例えば不自然な保存処理を見つけても、修正が現場の手順や周辺システムに与える影響は別に確かめなければなりません。現行の振る舞いを記述することと、刷新後にどうするかを決めることは違います。
未知には、調べ方の異なる複数の状態がある
解析で避けたいのは、把握した不明点を一つずつ解決することに集中し、それ以外には問題がないと思い込むことです。Known unknowns、つまり「何が分からないかは認識している」状態なら、必要な資料や実行結果を調べ、関係者に確認することで前進できます。一方、Unknown unknowns、そもそも調査・理解すべき観点が欠如し、問い自体を見出せていない状態では、どれだけ調査を行っても解明に届きません。
さらに、問いが見えているかどうかと、確かめるための材料があるかどうかも別の軸です。コードやログがなくて判断できないなら、資料の取得、実環境の観測、業務担当者への確認を検討する。一方、資料が十分にあっても、通常の呼び出し関係の外で動く処理を疑っていなければ、必要な箇所を見落とします。前者は根拠へのアクセスの問題であり、後者は問いを発見する能力の問題です。
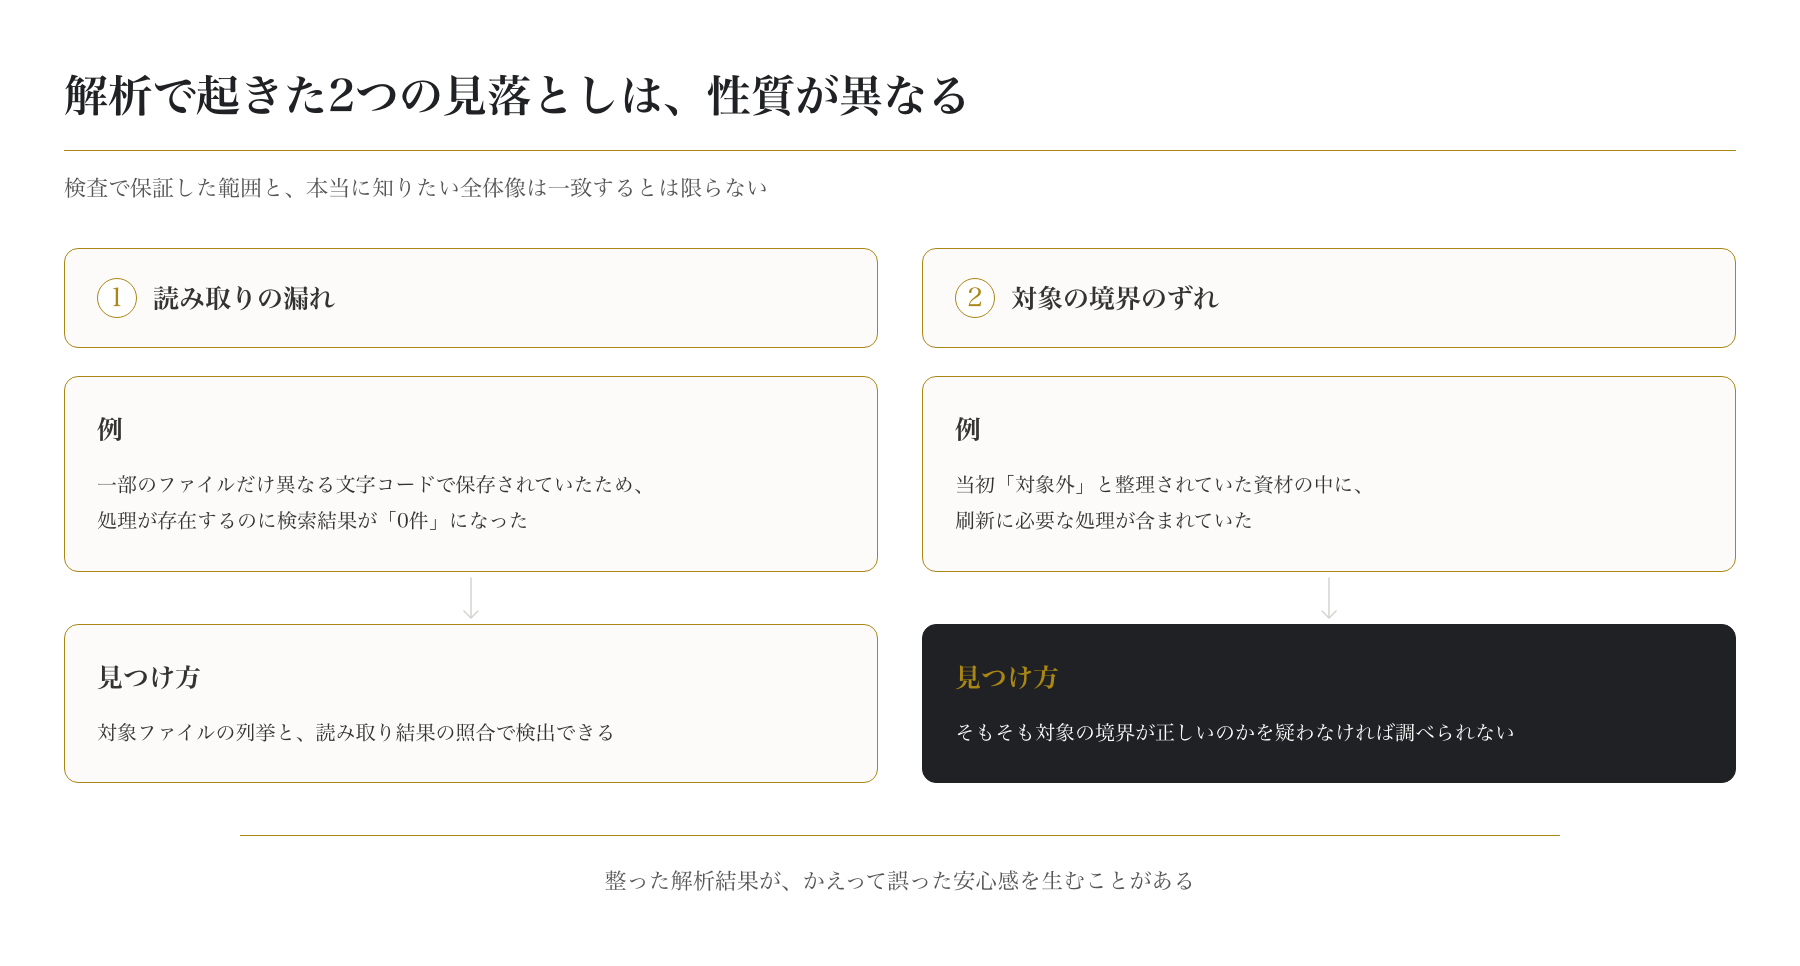
実際のある解析案件で、当初「対象外」と整理されていた資材の中に、刷新に必要な処理が含まれていたことがありました。受領した資材には対象や用途ごとの区分があり、まずはその区分に沿って調べるのが自然です。しかし、コード間の参照を追うと、対象内だけでは説明できない処理が見つかった。調査範囲を広げて初めて、対象外とされた側に必要な実装があると分かりました。指定された範囲をいくら丁寧に調べても、この欠落には気づけません。最初に渡された分類そのものを疑う必要があったのです。別の解析では、一部のファイルのみ異なる文字コードで保存されていたため、検索ツールが正しく認識できず、処理が存在するのに検索結果が「0件」となることもありました。
この二つは、見落としの性質が異なります。検索対象の読み取り漏れは、対象ファイルの列挙と読み取り結果の照合で検出できます。一方、対象外に必要な処理があるかどうかは、そもそも対象の境界が正しいのかを疑わなければ調べられません。検査で保証した範囲と、本当に知りたい全体像が一致するとは限らない。その違いを見失うと、整った解析結果がかえって誤った安心感を生みます。
網羅性を追求するだけでなく、仮説の前提を疑う
Unknown unknowns(未知の未知)には、最初から数えられる分母がありません。「未回答の質問がゼロ」となっても、まだ立てていない問いがないとは言えない。だから、無限の網羅性を約束するのではなく、判断の根拠と残る不確実性を明らかにします。
調査では機能の重要度に加え、発見が遅れた場合の影響や後から変更できる余地を考えます。確かめられる対象は再現性のある手法で検査し、前提のずれや資料間の矛盾は別の観点から探す。根拠が得られない事項をAIの推論で埋めず、影響とともに未確認として残します。
AIを信頼できるエンジニアリングに組み込む
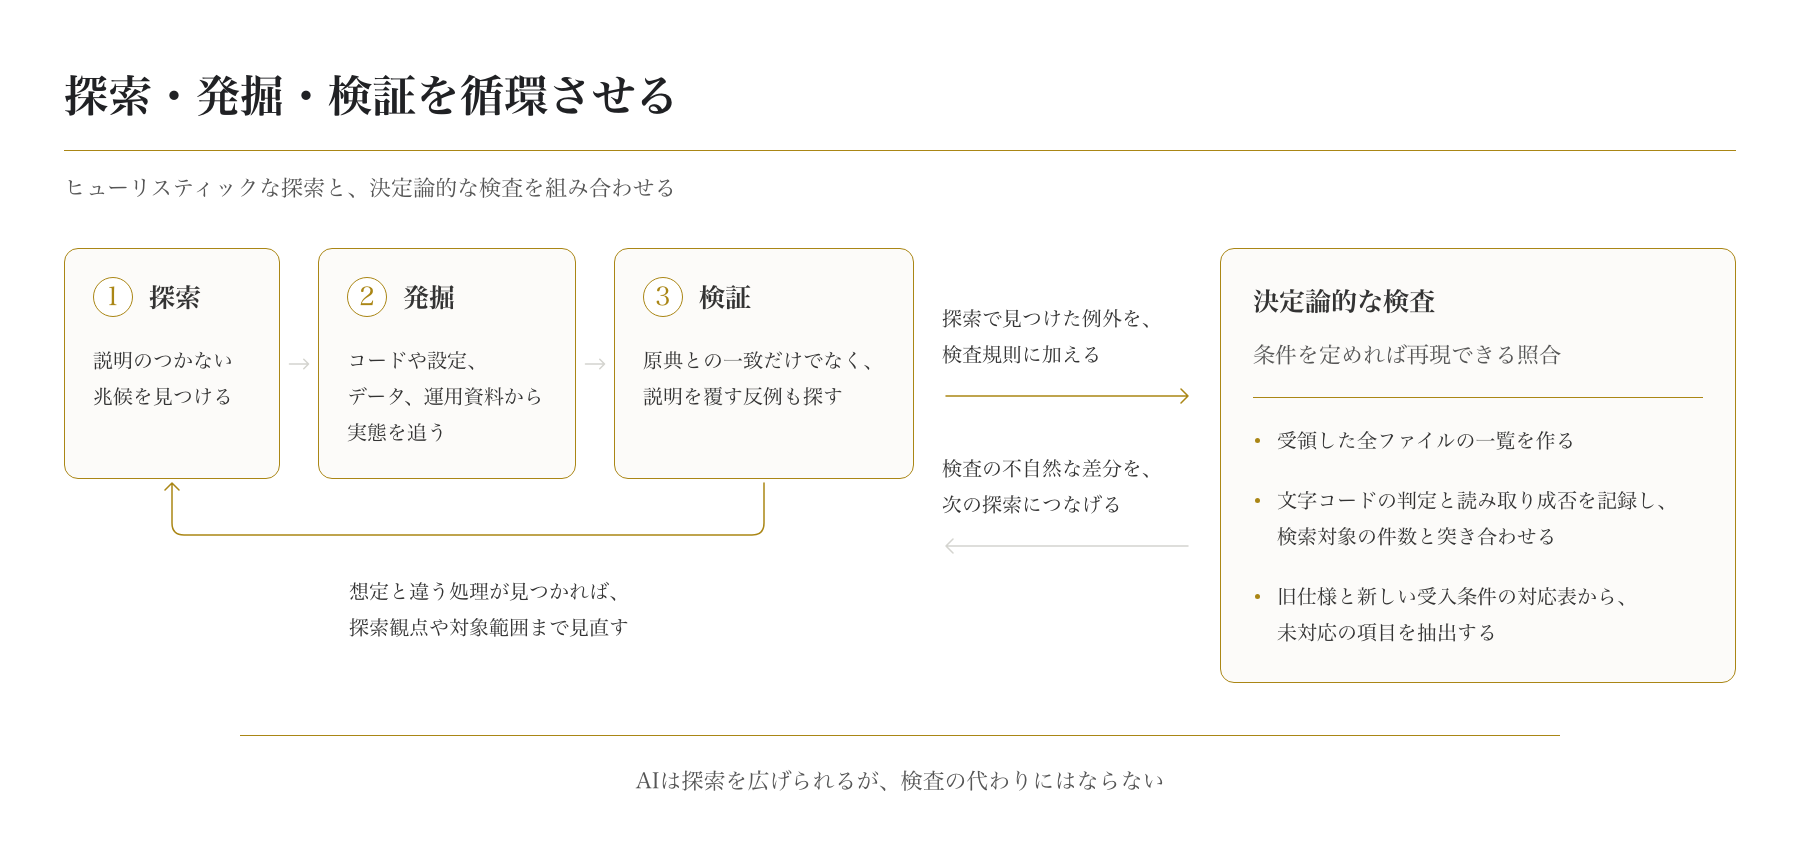
私たちは、決定論的な検査・判定と、ヒューリスティックな探索を組み合わせています。前者は条件を定めれば再現できる照合、後者はよくある技術負債の問題や違和感に基づいて仮説を立て、想定外の処理を探す活動です。AIは探索を広げられますが、検査の代わりにはなりません。
正確に数えられるものは、AIに推測させない
例えば、受領した全ファイルの一覧を作り、文字コードの判定と読み取り成否を記録し、検索対象の件数と突き合わせる。旧仕様と新しい受入条件の対応表についても、未対応の項目を機械的に抽出できます。こうした仕事はAIの「問題ありません」という説明より、同じ入力から同じ結果が得られる決定論的検査に任せるべきです。
しかし、ファイルを漏れなく読めたとしても、調査対象の指定が正しかったとは限りません。先ほどの対象外資材の例なら、対象内のコードが対象外の処理を参照していないか、似た機能で実装場所が不自然に違わないかを調べる必要があります。権限判定が画面側に見当たらないなら、共通処理やデータベース側にないかを疑う。こうした問いは、最初から完全な検索条件を用意しにくい領域です。AIには仮説と候補を広く挙げさせ、技術者が原典で裏付ける。
探索で見つけた例外を検査規則に加え、検査の不自然な差分を次の探索につなげる。AIが挙げた候補は原典と実行条件で裏付け、確認できない推論は事実と分けます。
探索・発掘・検証を循環させる
私たちは解析作業のなかで「探索・発掘・検証」を循環させています。探索で説明のつかない兆候を見つけ、発掘でコードや設定、データ、運用資料から実態を追い、検証で原典との一致だけでなく説明を覆す反例も探します。
検証で想定と違う処理が見つかれば、説明を直すだけでなく、探索観点や対象範囲まで見直す。解析を終えてから実装する一方向の工程ではなく、仮説と検証を行き来する方法です。
その往復から新しい検査規則が生まれ、別の機能でも使える知見が蓄積されます。
AIの誤り方を前提に、検証を独立させる
実際の解析案件では、存在する入力チェックを「ない」と書いたり、原典にない呼び出し関係を説明したりするAIの出力がありました。どちらも文章としては自然です。説明の説得力は、正確さの証拠にはなりません。
AIに自身の成果物を再点検させる方法も試しました。しかし、私たちが試した条件では費用が増えても発見できる誤りは増えず、逆に正しい記述を「未確認」とする例もありました。自己点検が常に無効なわけではないですが、同じ前提に基づく点検では前提自体の誤りを見逃し得る、ということです。
そこで生成と検証の役割を分け、原典との照合や反例の探索を重視しています。LLMのモデル特性による違いも考慮し、複数のモデルを使い分けることもありますが十分ではありません。「この説明は妥当か」ではなく「誤りだとしたら、どのコードや条件が反例になるか」と反証を求めるよう問うことが重要です。
AIが自分の出力に合わせて合格基準まで変えれば、基準を緩める危険があります。受入条件や網羅性の照合、重要な例外の扱いは独立して管理する。機械的に確かめられることは機械で確認し、業務上の意味は責任を持つ人が判断します。
作ることも、理解を深めるための手段になる
代表的な機能を早期にプロトタイプ実装し、利用者に動く画面や業務の流れを見てもらうと、資料だけでは表に出なかった条件や違和感が見つかります。私たちも、そのフィードバックを次の調査につなげています。
ただし、利用者がプロトタイプに納得しても、現行仕様の正しさが証明されたわけではありません。指摘をコードや運用の事実と突き合わせながら、作ったものから理解を更新する。AI開発の高速性・反復性を活かすことで、この往復を実務に組み込みやすくなりました。
現行環境を動かせない場合には、旧コードから期待値を読み起こして検証することもあります。ただし、その結果は読み起こした期待値との一致を示すのであって、現行システムの実動作との一致を証明するものではありません。こうした証拠の強さの違いを明示しながら、それでも前へ進める設計を持つことが重要です。
実践を、個人の技能から組織の方法論へ変える
解析対象となるレガシーシステムが変われば失敗の仕方も変わり、最初の手順が次にも通用するとは限りません。個別案件を進めると同時に、解析と検証の仕組み自体を改善する必要があります。
熟練技術者は、標準から外れた構造や不自然な依存関係から、別の場所に本当の処理があるのではないかと疑います。組織として残したいのは発見そのものだけでなく、何を手がかりに、どんな仮説を立て、どう確かめたかという思考の型です。
同じ欠陥を直すのではなく、発生する仕組みを直す
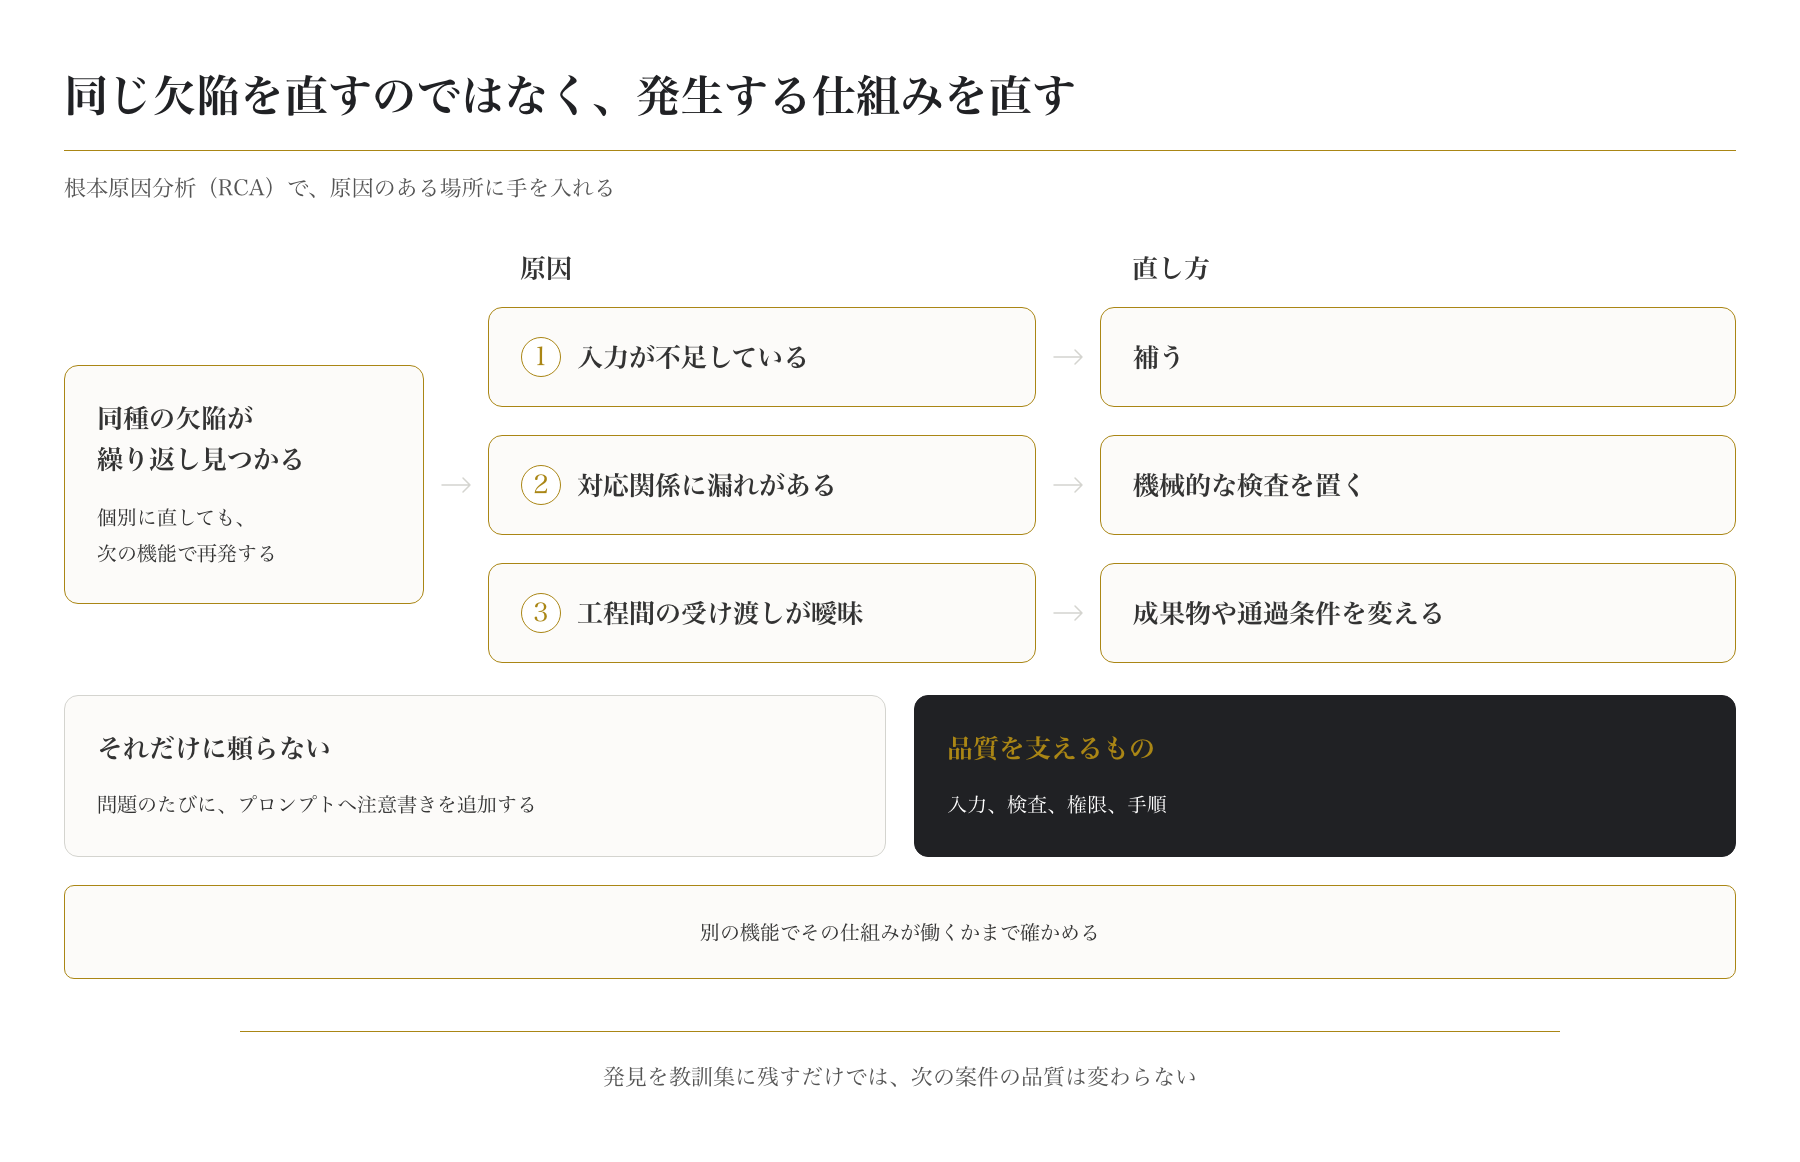
機能ごとの仕上げで、同種の欠陥が繰り返し見つかったことがあります。個別に直しても次の機能で再発するなら、入力情報、解析規則、検証項目のどこに原因があるかを調べなければなりません。
そこで根本原因分析(RCA、Root Cause Analysis)を取り入れています。入力が不足していれば補い、対応関係の漏れには機械的な検査を置く。工程間の受け渡しが曖昧なら、成果物や通過条件を変える。プロンプトやスキルの修正だけに頼りません。
問題のたびにプロンプトへ注意書きを追加しても、モデルや文脈が変われば再現できるとは限りません。注意喚起だけに頼らず、入力、検査、権限、手順で品質を支える。従来のエンジニアリングと同じ原則です。
発見を教訓集に残すだけでは、次の案件の品質は変わりません。誤りの原因と検出方法を結びつけ、解析手順や検査規則に反映する。別の機能でその仕組みが働くかまで確かめて、初めて普遍性のある能力になります。
汎用化するのは、個別の手順ではなく原則
最初の対象で成功した仕組みが、別の対象では前提の違い等によって通用しないことがあります。私たちも対象を広げた際、土台の複数箇所でこの問題に直面しました。
原典と推論を区別し、標準からの逸脱や反例を探し、判断の根拠を残す。これらは共通の原則です。一方、言語の構文、データベースの意味の差、業務固有の例外には、対象ごとの解析規則が要ります。
汎用化とは、どのシステムにも同じ検索式を当てることではありません。共通の品質原則を保ちつつ、対象に応じて仮説と検証方法を組み替えることです。別の技術構成でも同じ成果が出るとは限らず、適用結果は個別に確かめます。
熟練者の仮説形成の視点を、AIと他の技術者が使える探索観点に変える。新しい発見や失敗を次の検証へ戻すことで、個人の技能を組織の力に広げられます。
AI時代の刷新を、どう計画し判断するか
刷新を検討する企業には、予算や期間、事業への影響を見通す必要があります。しかし、現行システムの全体像が分からない段階で精密な見積もりを作っても、数字の細かさが計画の確かさを保証するわけではありません。
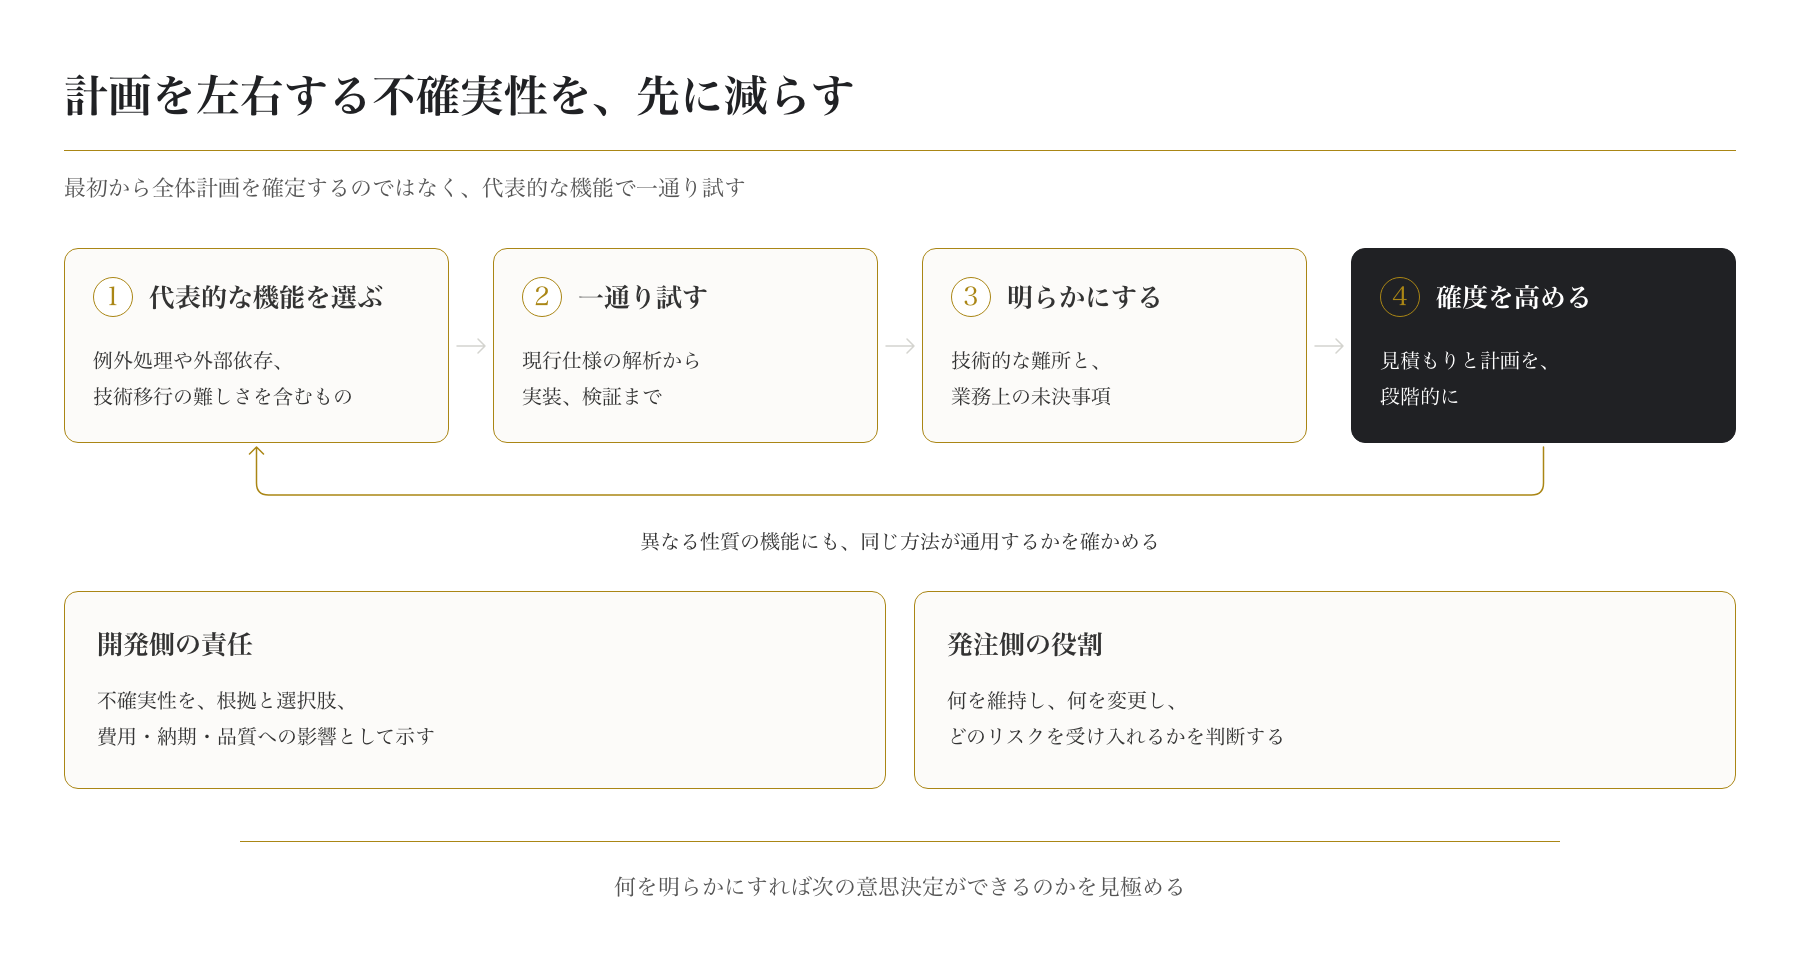
AIによって解析・試作・検証のコストが変わるなら、初期段階で優先すべきことも変わります。最初から全体計画を確定するのではなく、計画を左右する不確実性を先に減らすことです。
例えば、例外処理や外部依存、技術移行の難しさを含む代表的な機能を選び、現行仕様の解析から実装、検証まで一通り試す。そこで得られた知見から、技術的な難所や業務上の未決事項を明らかにし、見積もりと計画の確度を段階的に高めていきます。簡単な機能だけで成功を判断せず、異なる性質の機能にも同じ方法が通用するかを確かめることが重要です。
また、動くものを早く作れることと、業務システムとして完成を認められることは別です。業務全体の流れ、外部連携、データ移行、運用上の例外まで含め、何を検証できたか、何が未確認なのかを明らかにする必要があります。
開発側には、その不確実性を根拠と選択肢、費用・納期・品質への影響として示す責任があります。発注側には、それを踏まえて何を維持し、何を変更し、どのリスクを受け入れるかを判断する役割があります。
AI時代のレガシー刷新では、実装速度だけでなく、何を明らかにすれば次の意思決定ができるのかを見極める力が、計画の質を左右します。
古いコードを速く置き換えるだけでは、刷新は成功しません。引き継ぐべきものを理解し、検証可能な形にし、残る不確実性を判断できる状態へ変えていく。そこにこそ、AIによって刷新の進め方を変える意味があると考えています。