自分の考えを検討することから、他者と共同することへ
AIシステムに文章の修正を頼み、返ってきた案を見て、もう1度指示を出す。こうしたやりとりでは、同じ目標に向けて文章を直すこともあれば、伝え忘れていた背景を補うこともあります。案を見たことで、そもそも何を伝えたいのかを考え直す場合もあるでしょう。
AIとの対話は、自分だけでは思いつかなかった問いや案を検討する機会を増やします。一方、予測しきれない返答をどう受け止め、何を判断し、その過程を他者とどう共有するかは、より難しくなるのではないでしょうか。私は、この相互作用を扱うために、問題を捉え直し、案を作って確かめ、人と検討するデザインの知が、一般教養として重要になると考えています。
この可能性と難しさを考えるには、AIシステムが調整することと、人が判断することを分けて捉える必要があります。
1. インタラクションのモデル
人とAIシステムの働きを分けて考える手がかりに、Dubberly, Haque & Pangaro(2009)の分類があります。システム同士が働きかけ、応答する関係をインタラクションとして捉え、それぞれが何を調整できるかによって分けています。
分類に使う「次数」は、知能の高さや会話の回数ではなく、調整できるものの違いを表します。ここでいう目標は、実現しようとする状態や、満たそうとする条件です。
| 比較する項目 | 0次(反応する) | 1次(自己調整する) | 2次(学習する) |
|---|---|---|---|
| 結果を目標と比べて動作を調整する | できない | できる | できる |
| 目標そのものを見直す | できない | できない | できる |
| 例 | センサーの信号で開く自動ドア | 設定温度に近づけるエアコン | 快適さを考えて設定温度を変える人 |
0次(反応するシステム)は、入力に対して決まった仕方で出力を返します。出力の結果を目標と比べて、自分の動きを修正する仕組みはありません。たとえば、自動ドアのセンサーの信号でドアを開く仕組みがこれに当たります。
1次(自己調整するシステム)は、現在の状態を設定された目標と比べ、その差を小さくするように動きを変えます。たとえば、エアコンは室温を測り、設定温度に近づけるように運転を調整します。ただし、設定温度に当たる目標そのものを自分で変えることはできず、目標の変更は外部から行われます。
2次(学習するシステム)は、動作を調整する仕組みに加えて、その結果を評価し、目標を変える仕組みを持ちます。たとえば人が、設定温度を保っても寒いと判断し、快適に過ごせるように設定温度自体を見直す場合です。この理論モデルでは、行動の効果に基づいて目標を修正することを学習と呼びます。外部から条件を与えられているかどうかではなく、どの目標を自ら見直せるかが重要です(Dubberly, Haque & Pangaro, 2009)。
この3種類を2つずつ組み合わせると、6種類の関係になります。「0-1」は0次と1次、「1-2」は1次と2次の組み合わせを表します。
| 組み合わせ | 関係 | 定義 | 例 |
|---|---|---|---|
| 0-0 | Reacting(反応) | 一方の0次の出力が、もう一方の0次への入力となり、受け取った側が決まった反応を返します。 | 自動ドアのセンサーがモーターへ信号を送り、モーターがドアを開きます。 |
| 0-1 | Regulating(調整) | 0次の出力が1次への入力となります。外乱を受ける場合、1次は設定された目標を保つように動作を調整します。 | 列車が坂を上るときの抵抗が速度を乱し、速度を保つ装置が動作を調整します。 |
| 0-2 | Learning(学習) | 0次の出力が2次への入力となります。2次からも0次へ働きかけることで、2次は自分の働きかけの結果を確かめ、学ぶことができます。 | コンピュータの応答を人が受け取り、次の操作を試します。人は操作と結果の関係を学びますが、コンピュータは人について学びません。 |
| 1-1 | Balancing(均衡) | 一方の1次の出力が、もう一方の1次への入力となります。互いの出力を受け取る場合、それぞれが自分の設定された目標を保つように動作を調整します。 | 同じ部屋の冷房と暖房が、互いの運転で変わった室温を受けて動作を調整します。設定温度によっては、互いの働きを打ち消し合います。 |
| 1-2 | Managing(管理)/Entertaining(楽しませること) | 1次の出力が2次への入力となり、2次からも1次へ入力を返します。管理では2次が1次の目標を設定し、楽しませる関係では1次が2次の反応に応じて動作を調整します。 | 管理では、人が自動操縦装置の動作を受けて進行方向を設定します。楽しませる関係では、ゲームの提示を受けてプレイヤーが行動し、ゲームが上達に合わせて難易度を変えます。 |
| 2-2 | Conversing(会話) | 一方の2次の出力が、もう一方の2次への入力となります。双方が相手の働きかけを受けて学び、目標と実現方法を調整します。応答するかどうかは、それぞれが選べます。 | 人同士が案と理由を伝え合い、相手の説明を受けて考え直し、何を目指し、どう実現するかについて合意を目指します。 |
原論文は、当時の人とコンピュータの関係の多くを、0次のコンピュータと2次の人を組み合わせた「0-2 Learning(学習)」に位置づけています。人は操作と応答を通じてコンピュータの働きを学びますが、コンピュータの側は人について学びません。この関係を「You learn the system. But it does not learn you.」(あなたはシステムを学ぶ。しかし、システムはあなたを学ばない)と表現しています(Dubberly, Haque & Pangaro, 2009, 「0-2 Learning」節)。
では、結果や訂正を受けて動作を調整するAIシステムと人との関係は、どう捉えられるでしょうか。
2. AIシステムは、目標に向けて手段を調整する
AIシステムに記事の作成を頼み、返ってきた案に訂正を伝えると、その指摘を踏まえた案が返ってくる。このように、実行結果や訂正を受け取りながら達成方法を調整する場合を考えます。
たとえば、「読者が複数案を比較して判断できること」が記事の目標なら、比較表を作ることはその手段です。表の項目や説明の順序を直すことと、記事で読者に何をしてもらうかを変えることは、異なる調整です。
文章を生成するAIシステムの内部では、学習済みのLarge Language Model(大規模言語モデル)が回答を生成します。本稿では、この構成要素自体を「モデル」、必要に応じて外部メモリや検索・計算などのツールを組み合わせた全体を「AIシステム」と呼びます。
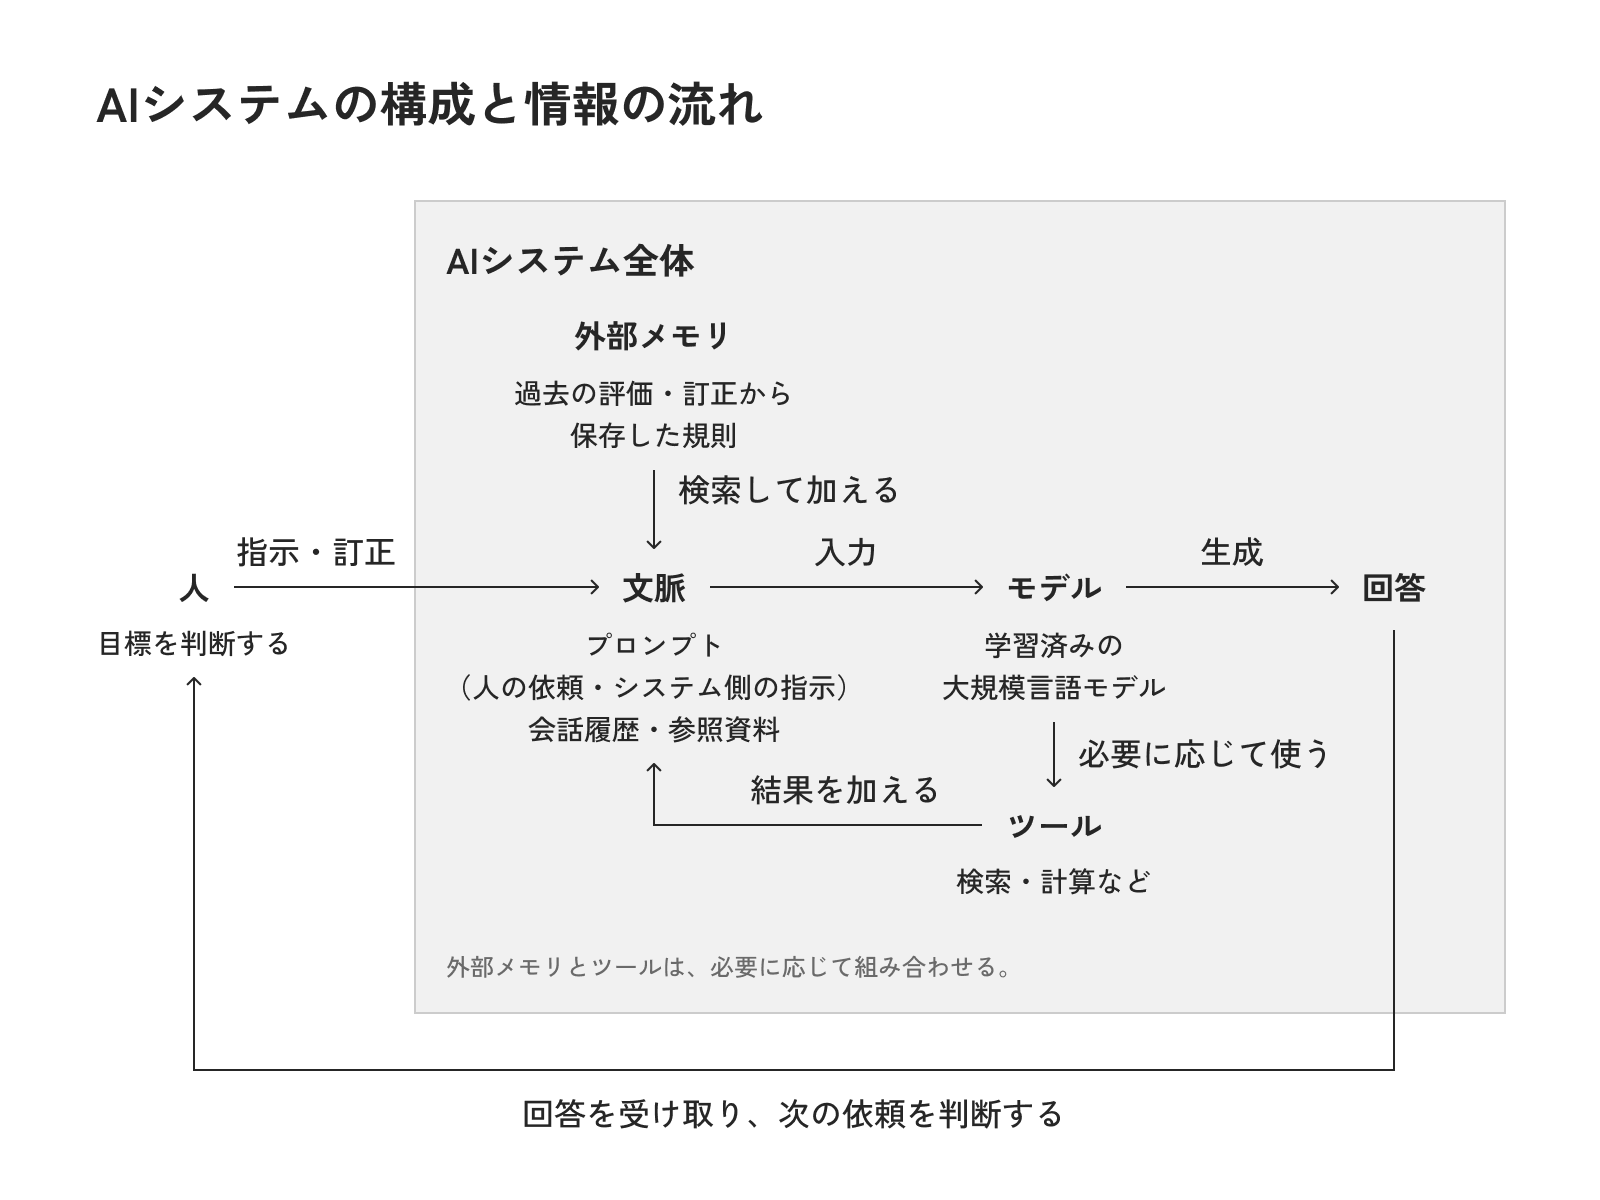
結果を評価した調整と、入力が変わったことによる返答の変化は区別する必要があります。モデルへの指示(プロンプト)には、人からの依頼とシステム側で設定する指示が含まれます。こうした指示や会話履歴、参照資料など、その回答を生成するときに使う情報を、ここでは「文脈」と呼びます。
同じモデルでも、与える文脈によって返答は変わります。Dherin ら(2025)は、モデルの学習済みの重みを書き換えずに、この変化が生じる仕組みを分析しています。
その文脈に過去の作業結果を加えれば、次の作業でも参照できます。Tablan ら(2026)は、銀行の顧客対応を模した課題で、評価や訂正から取り出した規則を外部メモリに保存する仕組みを試しました。「顧客がこういう状況なら、この操作をする」という規則を、次の作業で検索し、モデルへ与える文脈に加えます(Tablan ら, 2026, 第3.3節)。
この実験で更新するのは、目標を達成するための手段の規則です。タスクの目標そのものは更新しないと、著者らは明記しています(Tablan ら, 2026)。
私は、この結果に基づく手段の調整を1次の働きと解釈し、目標を見直せる人との関係を1-2の「管理」と捉えます。分類しているのは外部メモリを含むAIシステム全体です。
3. 返答を受けて、人は何を見直すのか
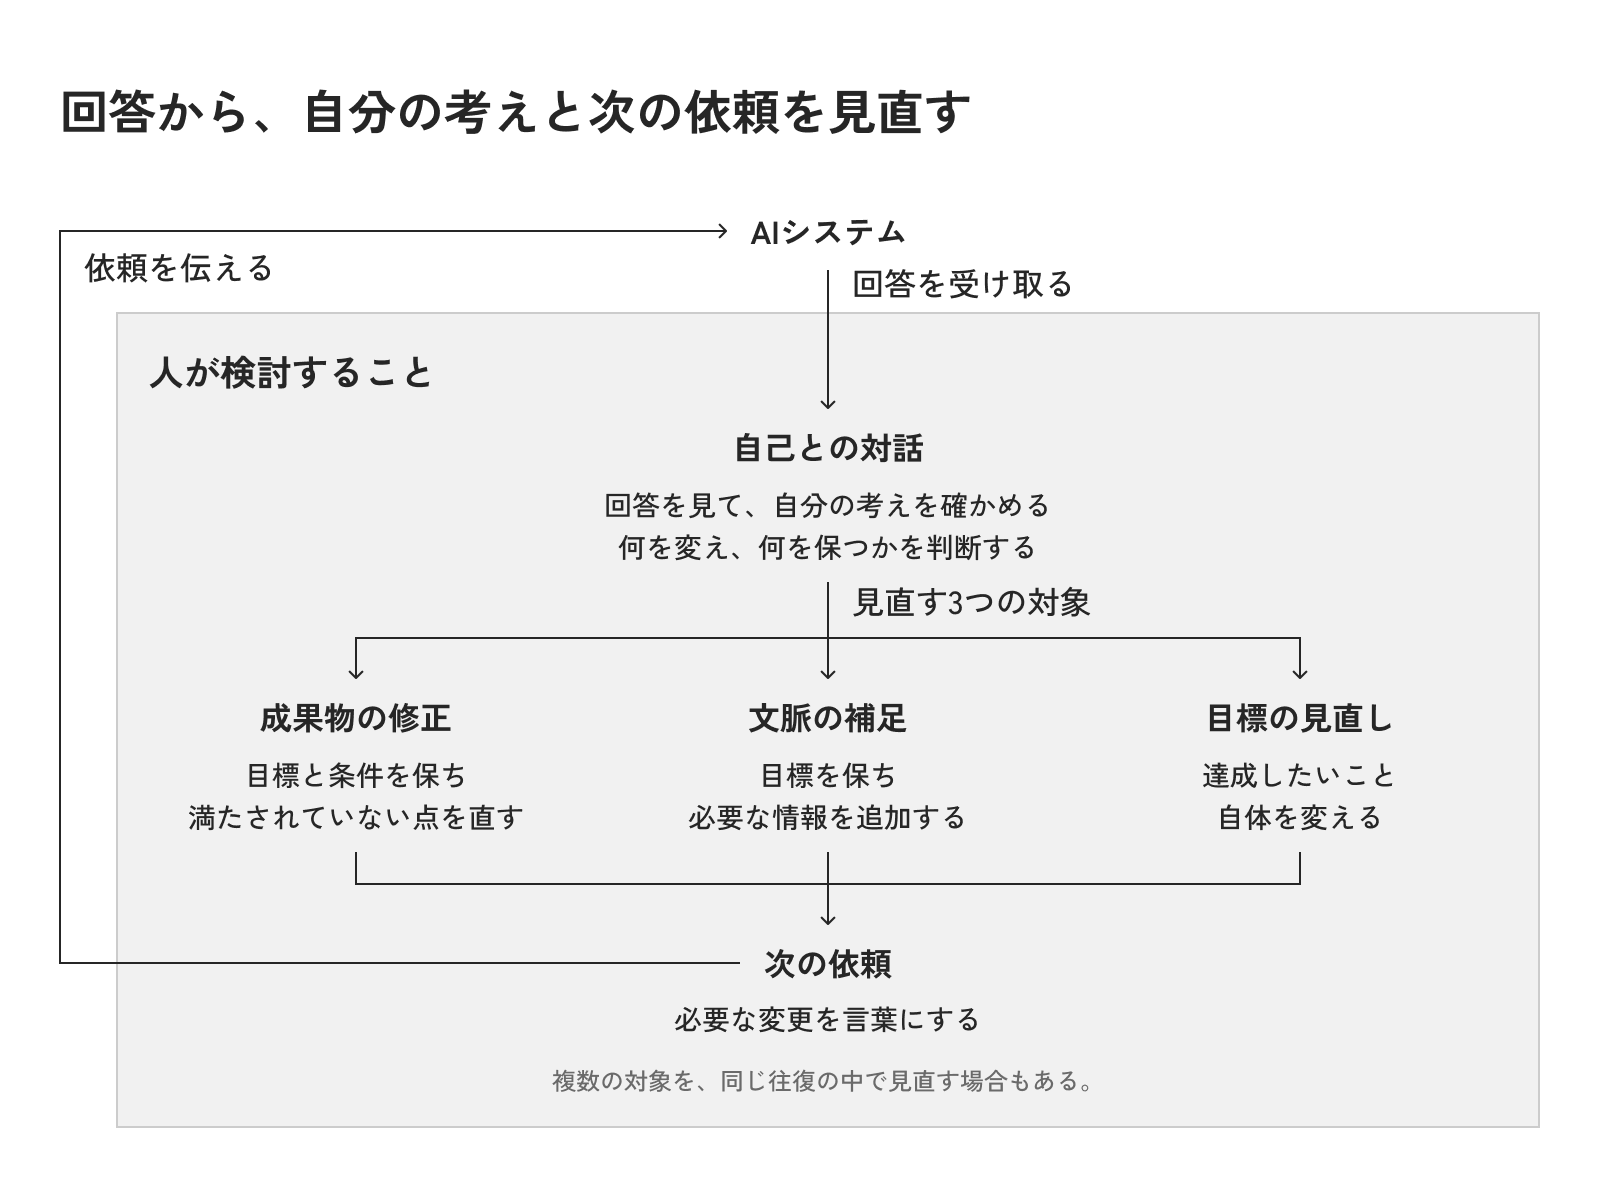
図1で示した、回答を受け取って次の依頼を判断するところでは、人は何をしているのでしょうか。返ってきた案を読み、期待と違う点を確かめると、成果物の不足に気づくことも、伝えていなかった条件や自分の目標を考え直すこともあります。
こうして回答を手がかりに自分の考えを確かめ、問い直すことを、ここでは「自己との対話」と呼びます。その検討を次の依頼に反映するとき、見直す対象を成果物・文脈・目標の3つに分けて考えます(図2)。
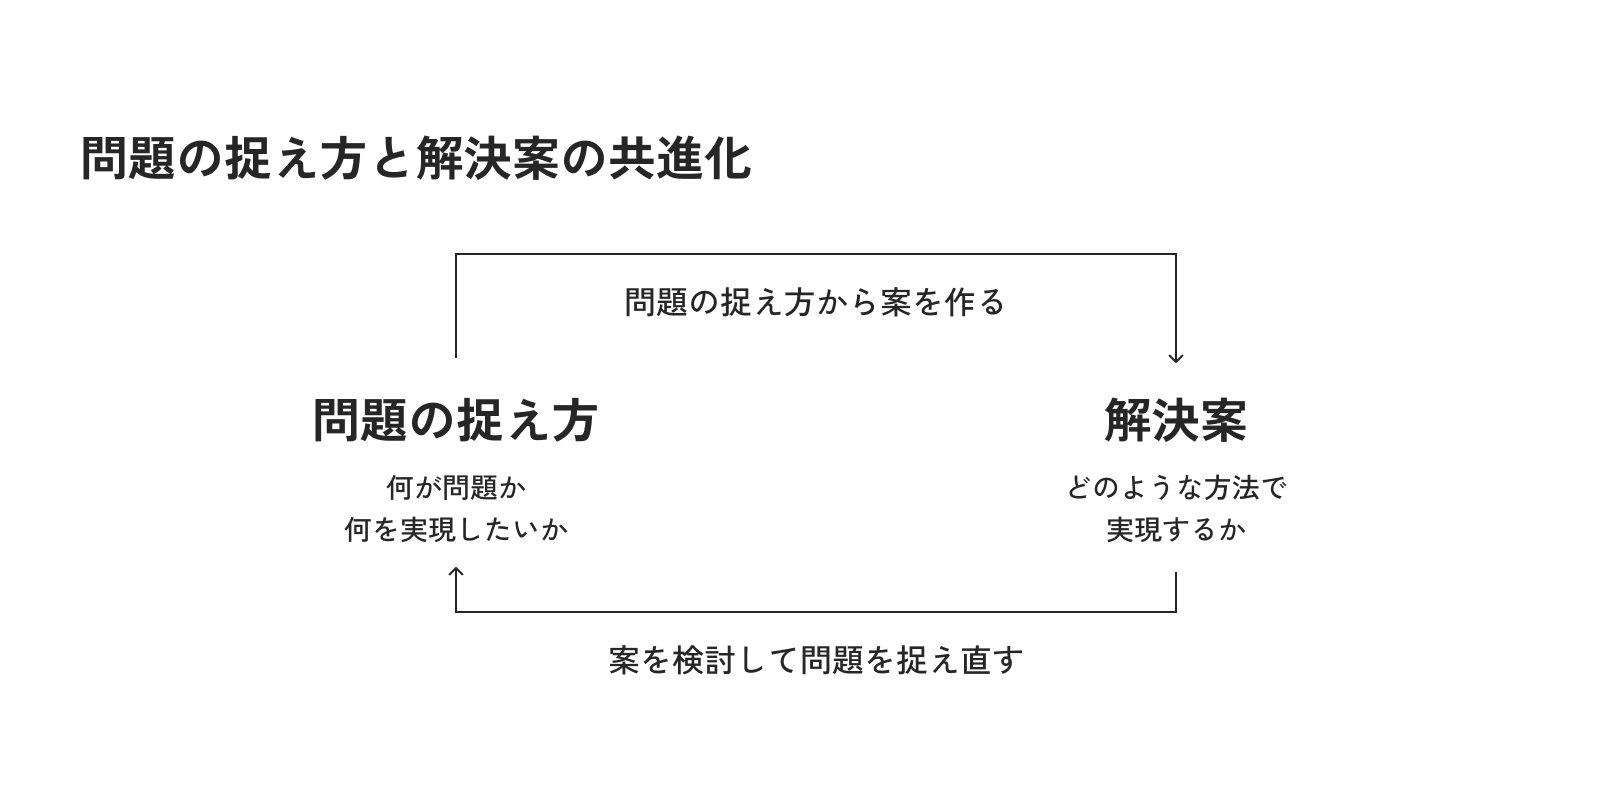
自分で書いた文章や描いた図を見て考え直すときにも、自己との対話は起こります。作った案を検討するうちに、解こうとしていた問題の捉え方自体が変わる場合があります。
Dorst & Cross(2001)は、列車内のごみ処理の仕組みを考えるデザイナーの思考過程を調べました。問題の捉え方と解決案が、互いの検討を通じて変わる過程を、co-evolution(共進化)として説明しています(Dorst & Cross, 2001)。
生成AIの出力も、人が問題の捉え方を検討するための情報になりえます。Guo ら(2024)は、初学者デザイナーが文章と画像の生成AIを使い、何をどのようなものとして作るかを考える概念設計を調べました。生成AIが人の仮説を立てる働きを促し、問題の捉え方を探ることを支援しうると述べています(Guo ら, 2024)。
ただし、出力を得られても検討が順調に進むとは限りません。Chen ら(2025)は、デザイナーへの調査で、生成AIを使いながら問題と解決案を同時に検討する難しさや、やりとりの負担、解決案の実用性の問題を報告しています(Chen ら, 2025)。
この難しさを踏まえると、AIが何を提示し、人が何を考えるかという役割の分け方が重要になります。Xu ら(2025)は、大学生によるデザインの演習で、AIが質問と回答をまとめて提示する使い方、質問を提示して人が回答する使い方、AIを使わない場合を比較しました。回答まで提示する場合には、参加者は内容の理解や統合に多くの時間を使いました。質問に人が回答する場合のインタビューでは、それまで考えていなかった問題を検討したという発言が報告されています。一方、質問が繰り返されたり、本人の優先事項から外れたりする問題もありました(Xu ら, 2025, 第5~6節)。
これらは概念設計や大学での演習を対象とした研究であり、一般の業務への適用や長期的な能力の向上を確かめたものではありません。また、返答から新たな見方を得ることが、そのまま目標の変更を意味するわけではありません。
期待と違う返答が、出力のぶれから生じる場合もあります。同じ入力に対して決まった結果を返すソフトウェアと比べると、生成AIでは、同じ入力でも生成時の確率的な選択によって返答が変わる場合があります。その程度はモデルや設定によって異なります。
図2の3つの対象を、記事を作る例で具体的に見てみます。
成果物の修正
目標と条件を保ち、満たされていない点を直すよう求めます。「伝えた比較項目が抜けているので追加して」という場合です。
文脈の補足
目標は保ち、必要な情報を追加します。「伝え忘れていたが、読者はこの分野の初学者なので、それを踏まえて」という場合です。評価基準を伝えるときも、以前から持っていた基準を初めて言葉にしたのか、基準そのものを変えたのかを区別します。
目標の見直し
達成したいこと自体を変えます。「この記事を見て、賛同を得るよりも、まず複数案を比較して判断してもらいたくなった」という場合です。
成果物の修正と文脈の補足では、人は目標を保ったままAIシステムに調整を求めます。目標を見直す場合には、人が変更を判断し、AIシステムは変更後の目標に向けて手段を調整します。いずれも、目標を見直すのは人であり、AIシステムが自らの目標を見直すわけではないため、本稿では1-2の関係として捉えます。
4. AIとの対話が、自己との対話を広げる
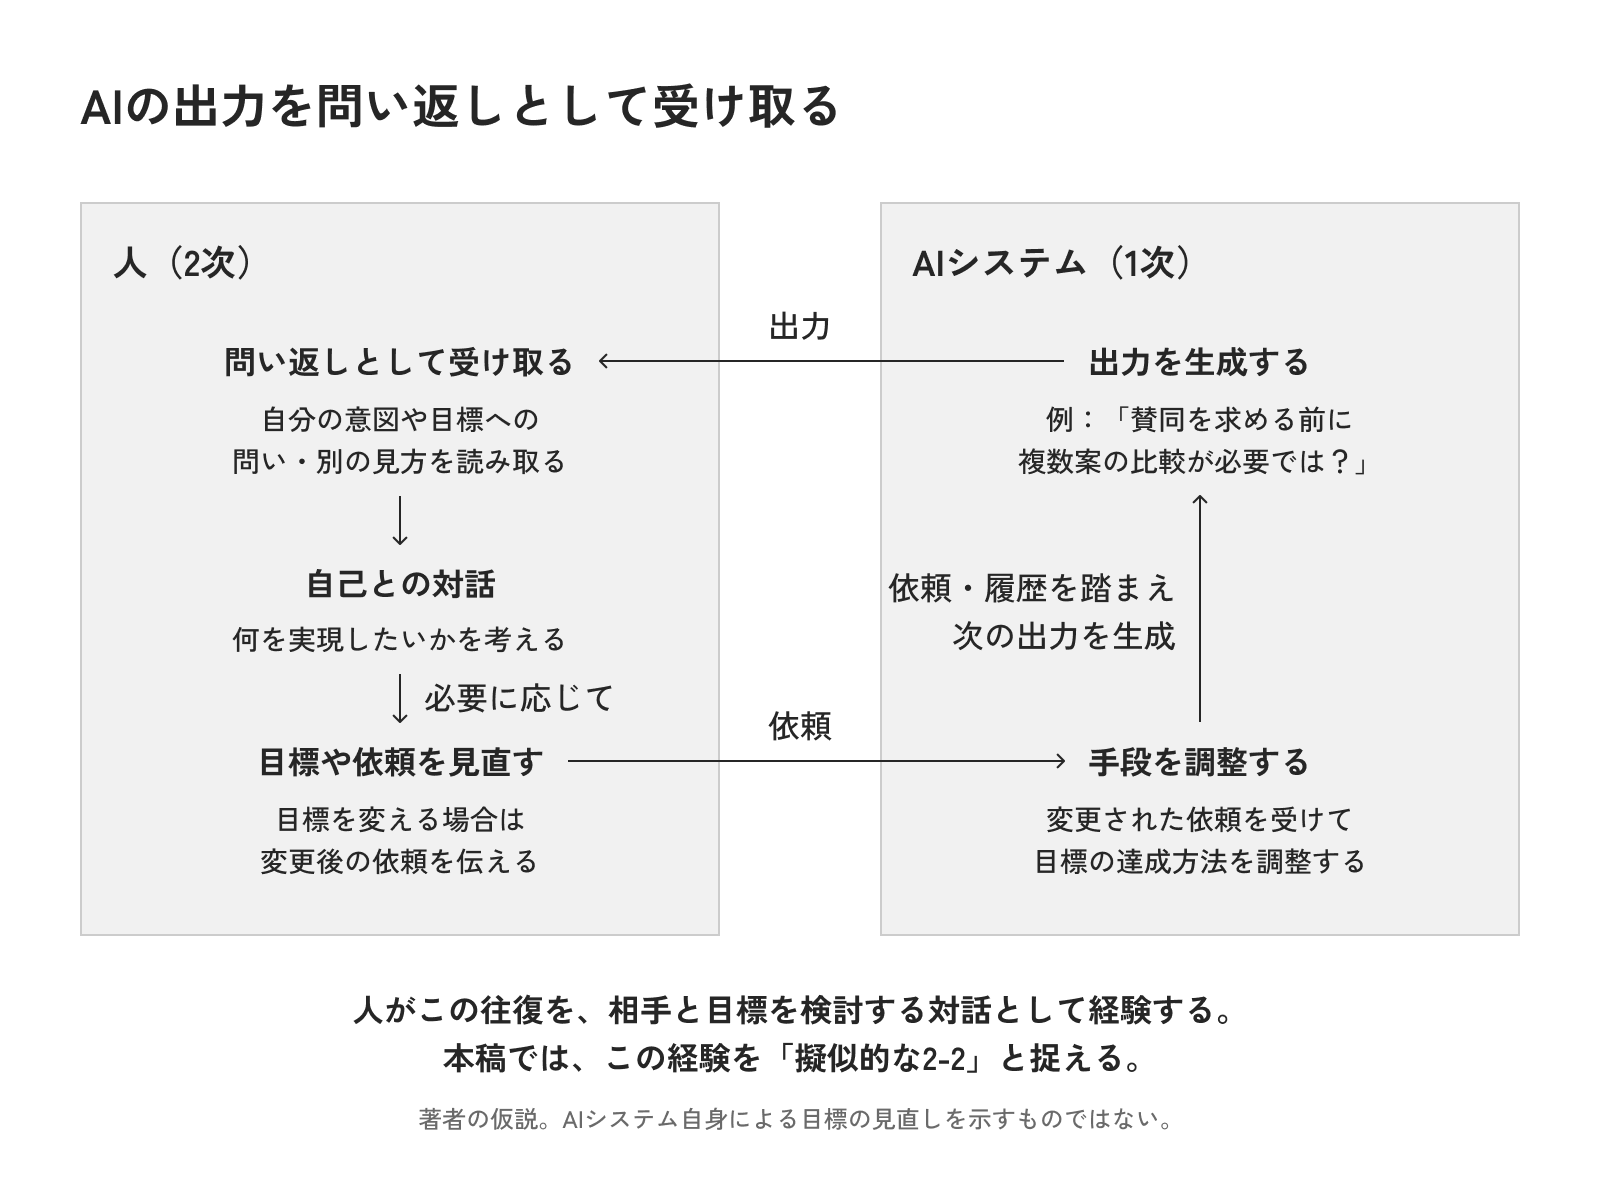
AIシステムの出力を、人が自分の意図や目標を問い返す応答として受け取る場合を考えます。出力から問いや別の見方を読み取り、自分が何を実現したかったのかを考え直す。私は、この受け取り方によって、自己との対話で検討できる範囲が広がると考えています。
3節の記事の例なら、「賛同を求める前に、複数案を比較してもらう必要はありませんか」という出力を、人が記事の目的への問い返しとして受け取る場合です。それを手がかりに考え、読者が案を比較して判断するための記事へ目標を変えます。変更後の依頼を伝えると、AIシステムが次の出力に使う文脈も変わり、人は返ってきた内容をさらに検討します。
私は、この往復を人が、あたかも相手と互いの考えや目標を検討しているかのように経験することを、「擬似的な2-2」と呼んでみたいと思っています(図4)。これは、1-2の関係にあるAIシステムとのやりとりを、人がどう受け取るかについての仮説です。Dubberly らの正式な分類でも、3節の研究で実証された類型でもありません。
予測しきれない返答は、自分では考えていなかった可能性を検討するきっかけになりえます。ただし、意外な案や返答のぶれを、そのまま有益と判断することはできません。どの問いを取り上げ、どの案を試すかを人が判断してこそ、検討を深められると考えます。
「擬似的」とするのは、人が相手と目標を検討しているように感じることと、AIシステム自身が目標を見直すことが、別だからです。人の側では実際に考えや目標が変わりえますが、人が出力を問い返しとして受け取ったことから、AIシステムにも意図や目標を問い直す働きがあるとは言えません。
ただし、AIの能力や仕組みが固定されていると考えることもできません。ダリオ・アモデイは、AIが次世代のAIを開発する能力を高めるrecursive self-improvement(再帰的自己改善)に言及し、その進展が人の理解と制御を上回ることを懸念しています(Amodei, 2026)。こうした能力の改善が進むときも、何を達成するための改善なのか、その目標を誰が見直すのかを分けて捉える必要があると考えます。
目標の見直しを仕組みに含める設計も提案されています。Wang ら(2026)は、現在の目標を保つ調整と、それでは対処できない状態が続いたときに目標の表現や下位目標を見直す調整を分けています。見直しには、人に確認を求める場合も含まれます(Wang ら, 2026, 第3.1節)。これは人とAIの2-2を実証したものではありませんが、AIが何を自ら見直せるようにするかという設計上の論点を示しています。将来、AIシステムも自らの目標を見直し、人と互いの目標を検討するなら、2-2として考えられます。
5. 人とAIとの対話を通じて、共同の目標をつくる
現実のプロジェクトでは、自分が納得するだけで仕事を進められるとは限りません。異なる考えや目標を持つ人と、何を実現するか、どの方法を選ぶかを検討します。互いの考えを受けて、それぞれが目標を見直せるこの関係は、本稿の分類では人同士の2-2として捉えられます。
Dubberly & Pangaro(2009)は、目標が比較的明確な場合の行動の調整と、目標そのものを交渉する協働を区別しています。共同で行動するためには、何を目指すかについても対話を通じた合意が必要だと述べています(Dubberly & Pangaro, 2009, 「What Does Conversation Offer?」の「Collaborate」節)。
そこに、4節で述べたAIとの対話が加わります。AIの出力を検討して自分の目標が変われば、人同士で検討すべき内容も変わります。他者から異なる考えを受け取れば、AIへの依頼や、出力を評価する基準も変わります。図5は、この2つの対話を行き来しながら、共同の目標を検討する関係を示しています。
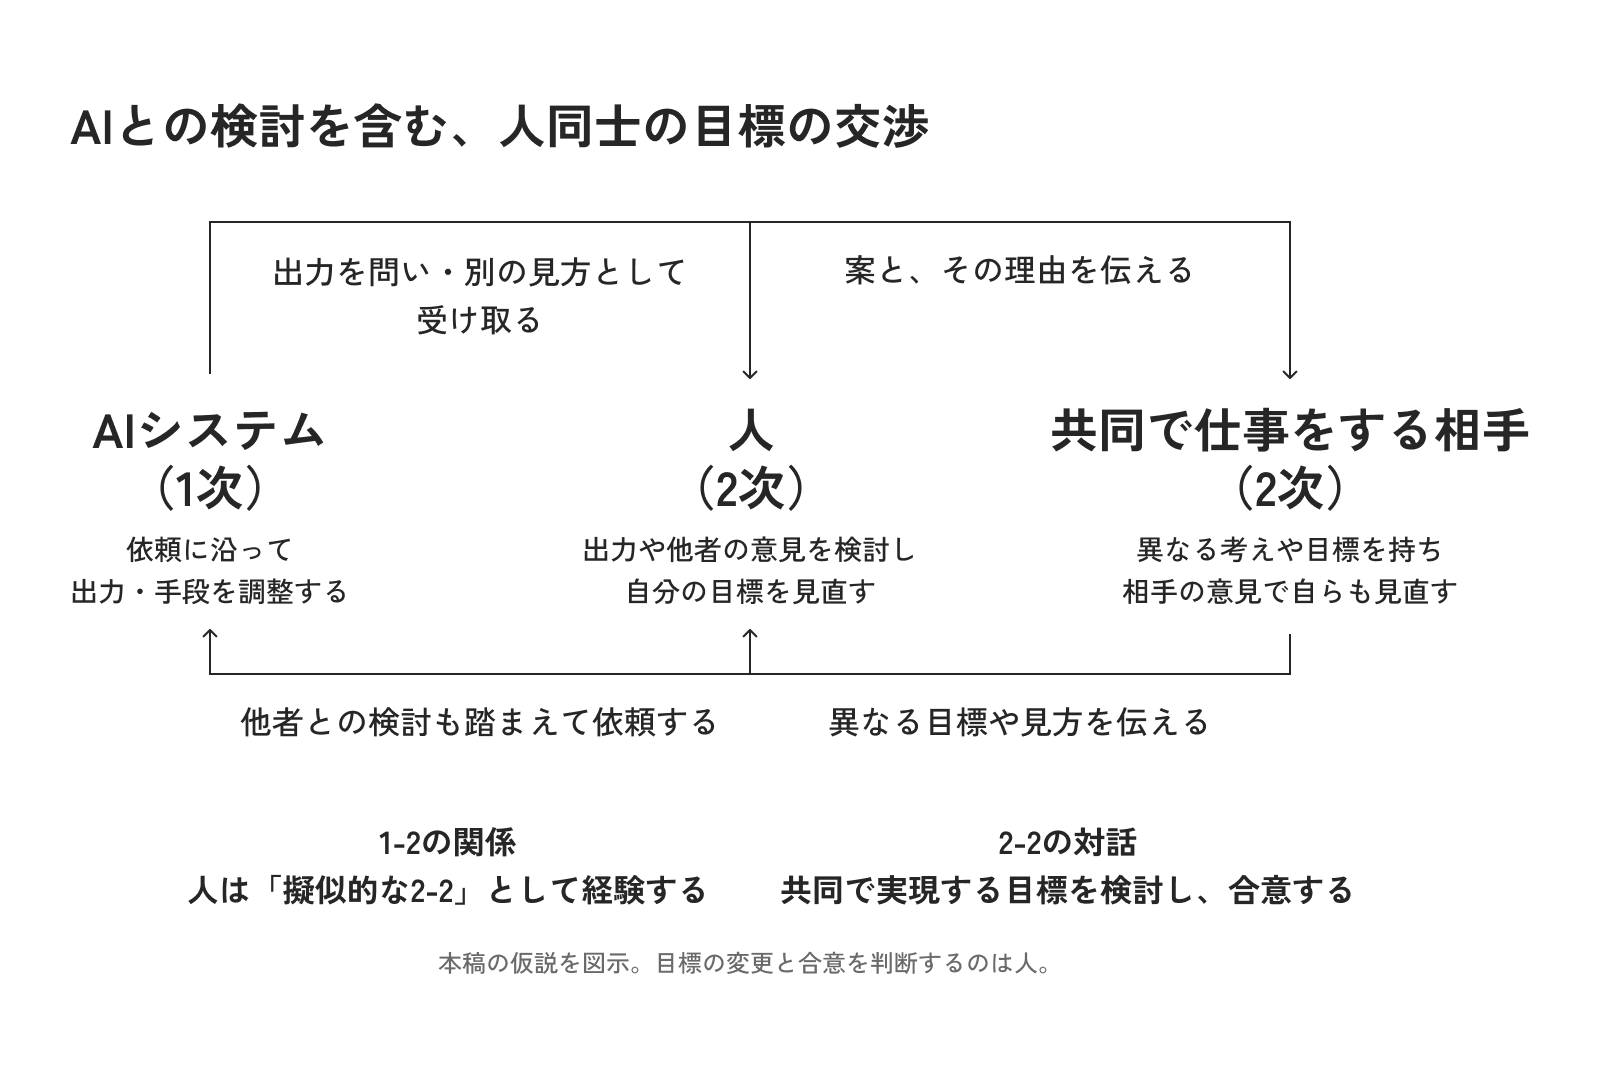
たとえば記事を共同で作るとき、自分はAIとの検討を経て「読者に複数案を比較してもらいたい」と考え、共同制作者は「特定の案への賛同を得たい」と考えている場合です。比較と賛同のどちらを優先するのか、なぜそうしたいのかを話し合い、双方が記事の目標を見直します。その検討を踏まえてAIシステムに構成案を作らせ、案を見ながら、読者に何を判断してもらうかを再び話し合うことができます。
このとき、自分の目標、共同で目指す目標、AIシステムに伝えた目標の間に、ずれが生じることがあります。AIとの検討で自分の考えが変わっても共同制作者には伝わっていない、人同士で合意した内容が次の依頼に反映されていない、といった場合です。人同士の2-2と、擬似的な2-2として経験するAIとの対話が互いに影響することで、何を誰と確かめ、何に合意するかという判断は、さらに複雑になると考えます。
異なる目標を持つ人が、案を作り、その意味や結果を確かめながら、共同で実現したいことを考える。私は、この過程を扱うことを、デザインの本質的な働きの1つと捉えています。合意形成には、相手の考えによって、自分の問題の捉え方や案も見直せることが必要です。designing for conversations(対話のための設計)も、こうした相互の検討と合意を可能にする過程をつくることだと捉えています。
人同士の協働を支えてきたこの知は、引き続き必要です。そして、AIとのやりとりも目標を問い直す対話として経験されるなら、何を問い、案をどう確かめ、次の判断につなげるかというデザインの知を、AIとの対話にも活用する場面が広がっているのではないでしょうか。
6. 一般教養としてのデザインが重要になる
AIツールは使えるようになったけれど、仕事で何にどう使えばよいか迷う。そのような人にこそ、ここまで述べてきたデザインの知が役立つのではないかと思います。操作方法に加えて、何を問い、返ってきた案のどこに注目し、次に何を試すかを考えるための知です。
今の仕事を効率よく進めることは、AIの大切な使い道です。そこからさらに、出力に表れた別の見方を検討し、当たり前だと思っていた問題や目標を問い直すこともできます。案を作って確かめ、人と話し合ううちに、誰のために何を実現したいのかが変わるかもしれません。私は、この過程に、物事を新しい角度から捉え、より創造的で豊かな価値を生み出す可能性があると考えています。
サイモンは、現状をより好ましい状態へ変えるための行動を考案する人は、誰でもデザインをしていると述べています(Simon, 1988, p.67)。この捉え方に照らせば、AIシステムを使って案を検討し、人と何を実現するかを調整することも、デザインの活動として考えられます。
私は、こうした活動に参加するための知を、一般教養としてのデザインと捉えたいと思います。目の前の仕事で気になっていることを問いにし、AIの出力を自分の経験や他者の見方と照らして、案を試す。AIツールを現場で使えるようにするとともに、こうした考え方と実践を学ぶ機会も広げていくことが、専門家に限らず、一人ひとりが新しい価値をつくることにつながるのではないでしょうか。
参考文献
- Simon, H. A. (1988). The Science of Design: Creating the Artificial. Design Issues, 4(1/2), 67–82. https://doi.org/10.2307/1511391
- Amodei, D. (2026, September). We Must Pace the Frontier. https://darioamodei.com/post/we-must-pace-the-frontier
- Wang, X., Yang, C., Zhao, H., Lin, Z., & Hu, S. (2026). The Agent Use of Agent Beings: Agent Cybernetics Is the Missing Science of Foundation Agents (arXiv:2605.10754) [Preprint]. arXiv. https://arxiv.org/abs/2605.10754
- Chen, P., Wu, Y., Li, Z., Zhang, H., Zhou, M., Yao, J., You, W., & Sun, L. (2025). GPSdesign: Integrating generative AI with problem-solution co-evolution network to support product conceptual design. International Journal of Human–Computer Interaction, 41(19), 12130–12150. https://doi.org/10.1080/10447318.2025.2453003
- Dherin, B., Munn, M., Mazzawi, H., Wunder, M., & Gonzalvo, J. (2025). Learning without training: The implicit dynamics of in-context learning (arXiv:2507.16003) [Preprint]. arXiv. https://arxiv.org/abs/2507.16003
- Dorst, K., & Cross, N. (2001). Creativity in the design process: Co-evolution of problem–solution. Design Studies, 22(5), 425–437.
- Dubberly, H., Haque, U., & Pangaro, P. (2009). What is interaction? Are there different types? Interactions, 16(1), 69–75. https://doi.org/10.1145/1456202.1456220
- Dubberly, H., & Pangaro, P. (2009). What is conversation? How can we design for effective conversation? https://www.dubberly.com/articles/what-is-conversation.html
- Xu, X. (T.), Konnova, A., Gao, B., Peng, C., Vo, D., & Dow, S. P. (2025). Productive vs. Reflective: How Different Ways of Integrating AI into Design Workflows Affect Cognition and Motivation. CHI 2025, Article 24, 1–15. https://doi.org/10.1145/3706598.3713649
- Guo, J., Yin, Y., Sun, L., & Chen, L. (2024). Empirical study of problem-solution co-evolution in human-GAI collaborative conceptual design. In DRS2024. Design Research Society. https://doi.org/10.21606/drs.2024.983
- Google Cloud. Content generation parameters(コンテンツ生成の設定). 取得 2026年9月14日, https://docs.cloud.google.com/gemini-enterprise-agent-platform/models/capabilities/content-generation-parameters
- Tablan, V., Taylor, S., & Bernhem, K. (2026). Learning on the job: Continual learning from deployment feedback for frozen-weights agents (arXiv:2607.22157) [Preprint]. arXiv. https://arxiv.org/abs/2607.22157